
Overview
운영 중인 서비스를, 실제 관리 흐름부터 다시 설계했습니다.
Washer는 광주소프트웨어마이스터고 기숙사에서 실제로 운영되는 세탁기·건조기 예약 서비스입니다.
v1 역시 실제 서비스되고 있었지만, 관리자 기능이 운영 업무를 충분히 대체하지 못해 기기 상태 확인이나 문제 대응 과정에서 수기 업무가 함께 이뤄지고 있었습니다. 또한 기능이 추가되면서 관리자 코드와 데이터 처리 로직도 한 화면에 집중되어 유지보수가 어려워지고 있었습니다.
Washer Client v2에서는 기존 화면을 단순히 개선하는 대신, 디자인부터 관리자 정보 구조, 실제 운영 방식, 프론트엔드 데이터 구조까지 전면 재설계했습니다.
운영 대상이 약 210명에서 280명 규모로 확대되는 과정에서, 예약·기기·사용자·고장 신고를 하나의 관리자 서비스에서 관리할 수 있는 구조를 만드는 데 집중했습니다.
Problem
서비스는 운영되고 있었지만, 관리 업무는 여전히 서비스 밖에 남아 있었습니다.
v1 서비스는 실제로 운영되고 있었지만, 관리자 운영까지 충분히 시스템화되지는 못했습니다.
기기 이상이나 사용 중 문제가 발생하면 학생이 사관선생님에게 직접 전달했고, 관리자는 필요한 내용을 수기로 확인하며 대응했습니다. 기기 상태, 예약, 사용자 패널티, 고장 신고와 같은 정보도 서로 분산되어 있어 관련 내용을 함께 확인하고 처리하기 어려웠습니다.
기존 프론트엔드 구조 역시 관리자 기능이 하나의 페이지에 집중되어 있었습니다. v1 관리자 페이지는 1,600줄 이상까지 증가했고, API 호출·데이터 변환·모달 상태·사용자 액션·UI 렌더링이 하나의 파일 안에서 함께 관리되고 있었습니다. 기능이 추가될수록 수정 범위를 파악하기 어려워졌고, 새로운 기능을 붙이는 과정에서도 기존 로직과의 영향을 함께 확인해야 했습니다.
따라서 v2에서는 두 가지 문제를 함께 해결해야 했습니다.
01. 운영의 문제
수기로 남아 있던 관리자 업무를 서비스 내부로 가져오고, 기기·예약·사용자·고장 신고 정보를 연결해 확인하고 처리할 수 있도록 만드는 것
02. 구조의 문제
한 파일에 집중된 API 호출·데이터 처리·상태 관리·사용자 액션·UI 책임을 분리하고, 기능이 추가되어도 유지보수할 수 있는 구조로 다시 만드는 것
Experience
조회에서 끝나지 않고, 조치까지 이어지는 관리자 흐름을 설계했습니다.
v1의 관리자 기능을 다시 살펴보면서, 단순히 관리 정보를 한곳에 모아 보여주는 것만으로는 실제 운영을 충분히 대체하기 어렵다고 판단했습니다.
관리자는 기기나 예약 상태를 확인하는 데서 업무가 끝나는 사용자가 아니었습니다. 문제가 발생한 대상을 찾고, 관련 정보를 확인한 뒤 기기 상태 변경·예약 취소·패널티 해제·신고 처리와 같은 후속 조치까지 수행해야 했습니다.
그래서 화면을 구성할 때 “무엇을 보여줄 것인가”보다 “이 정보를 확인한 뒤 관리자가 무엇을 해야 하는가”를 기준으로 각 기능의 조회와 조치가 이어지도록 설계했습니다.
| 관리 영역 | 확인 | 이어지는 조치 |
|---|---|---|
| Machines | 기기 상태 · 사용 가능 여부 | 기기 상태 변경 |
| Reservations | 현재 예약 · 예약 이력 | 예약 취소 |
| Users | 사용자 정보 · 패널티 상태 | 패널티 해제 |
| Reports | 고장 신고 내용 · 처리 상태 | 신고 상태 변경 |
| Dashboard | 기기 · 예약 · 신고 현황 | 필요한 관리 화면으로 이동 |
이를 통해 관리자 화면을 단순한 데이터 조회 도구가 아니라, 문제를 발견하고 → 필요한 정보를 확인하고 → 바로 조치할 수 있는 운영 도구로 만드는 것을 목표로 했습니다.
관리자가 필요한 정보에 빠르게 도달하도록 설계했습니다.
관리 업무에서는 많은 데이터를 한 번에 보여주는 것보다, 문제가 발생한 대상과 범위를 빠르게 특정하고 필요한 정보를 단계적으로 확인할 수 있는 구조가 중요했습니다.
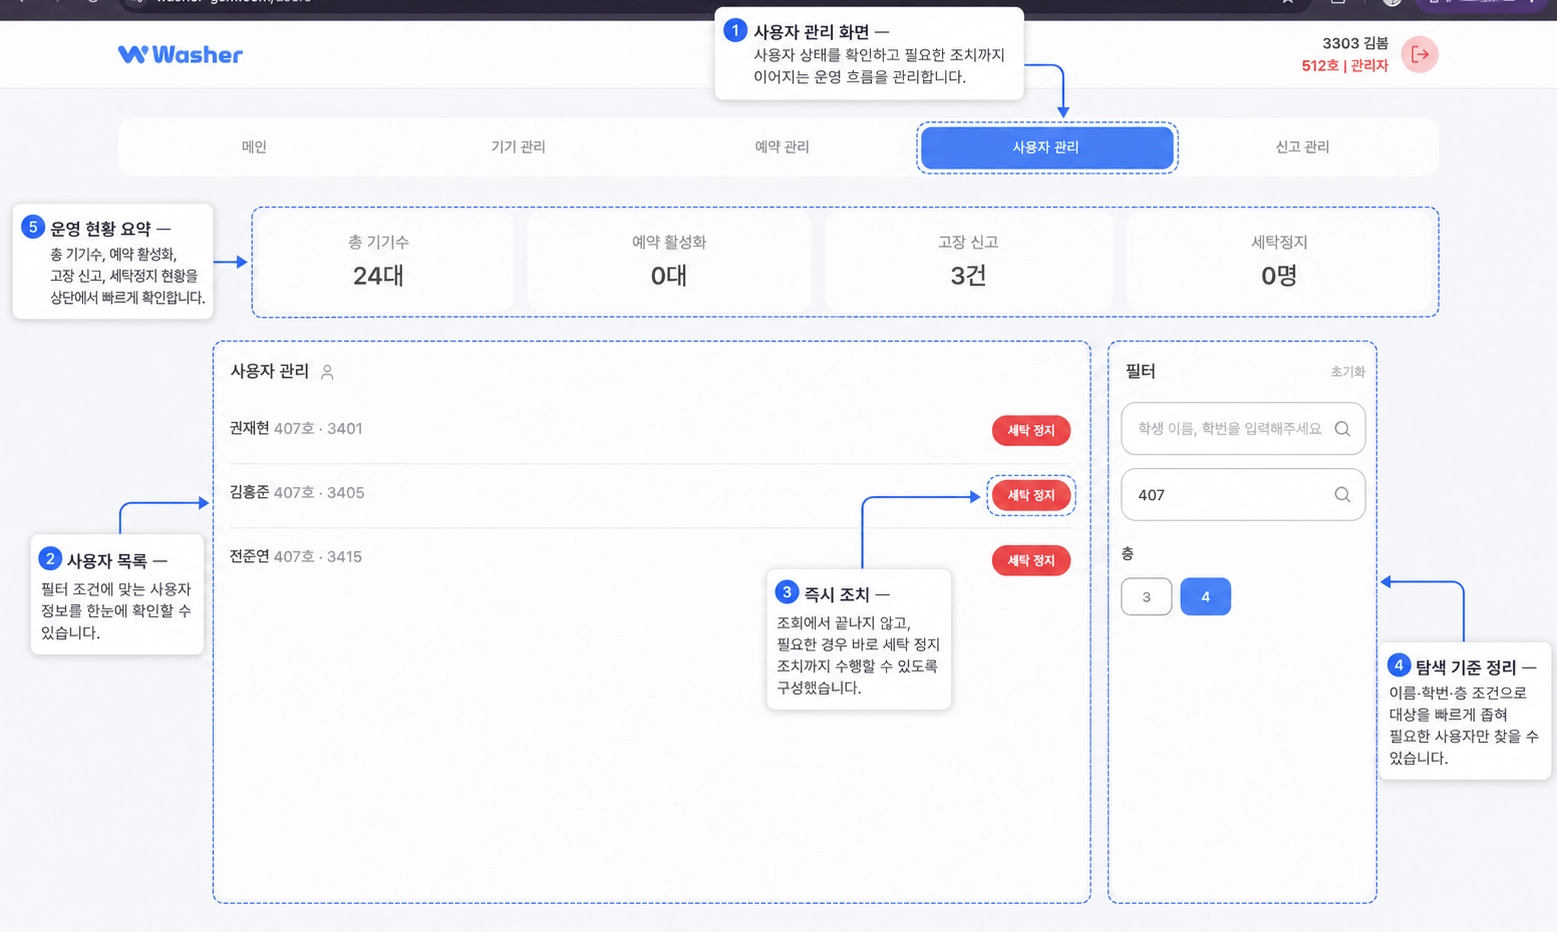
사용자 관리 화면에서는 이름·학번·층을 기준으로 대상을 찾을 수 있도록 필터를 구성했습니다. 관리자가 특정 학생이나 층을 빠르게 찾고, 목록에서 상태를 확인한 뒤 필요한 경우 같은 화면에서 바로 세탁 정지와 같은 조치까지 이어갈 수 있도록 했습니다.
고장 신고 화면에서는 관리자가 특정 층에서 발생한 문제를 확인하는 상황을 고려했습니다. 신고 데이터에는 층 정보가 직접 포함되어 있지 않았기 때문에, 단순한 필터만으로는 특정 층의 신고를 바로 찾기 어려웠습니다.
그래서 선택한 층의 기기를 먼저 찾고, 기기와 신고가 공통으로 가지고 있는 machineId를 기준으로 관련 신고를 연결하는 방식으로 구성했습니다.
층 선택 → 해당 층의 기기 확인 →
machineId로 관련 신고 연결 → 해당 층의 신고만 표시
이를 통해 관리자는 전체 신고 목록에서 기기를 하나씩 확인하지 않고, 문제가 발생한 위치를 기준으로 필요한 신고만 빠르게 좁혀볼 수 있었습니다.
예약 관리에서도 같은 기준을 적용했습니다. 현재 예약을 확인하다 특정 기기의 이전 이용 내역이 필요한 경우, 별도의 이력 화면으로 이동하면 현재 확인하던 맥락이 끊길 수 있다고 봤습니다.
그래서 현재 예약 화면을 유지한 채 History 버튼을 통해 해당 기기의 예약 이력을 패널에서 바로 확인할 수 있도록 연결했습니다.
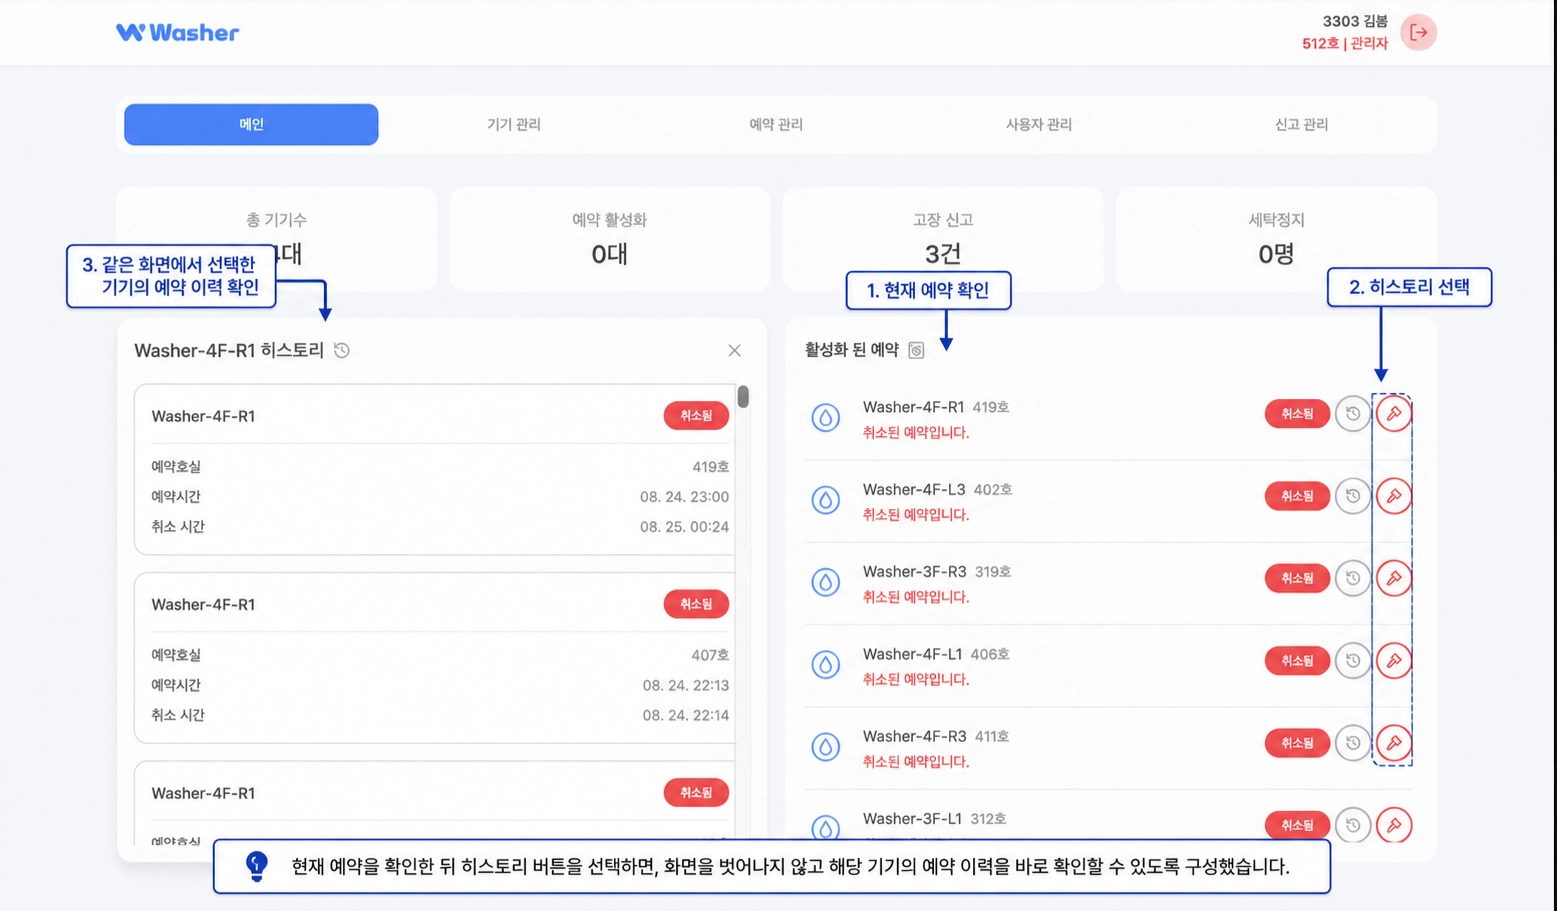
결과적으로 관리자가 전체 데이터를 반복해서 훑는 대신, 문제가 발생한 범위를 좁히고 → 관련 정보를 확인하고 → 필요한 조치로 이어질 수 있도록 탐색 단계를 정리했습니다.
로그인 오류를 사용자 경로의 문제로 다시 정의했습니다.
실제 운영 중 일반 사용자가 관리자 웹에 접속한 뒤 **“Washer 로그인이 되지 않는다”**고 전달한 사례가 있었습니다.
시스템 입장에서는 관리자 권한이 없는 사용자의 접근이었지만, 사용자는 자신이 관리자용 페이지에 들어왔다는 사실을 알기 어려웠습니다. 그래서 권한 문제를 서비스 자체의 로그인 오류로 받아들이고 있었습니다.
이를 단순한 인증 실패로 처리하기보다 사용자가 잘못된 경로에 진입했을 때 다음 행동을 안내해야 하는 문제로 다시 봤습니다.
이후 일반 사용자가 관리자 웹에 접근하면 인증 정보를 무조건 삭제하지 않고, 사용자용 앱을 이용할 수 있도록 앱 다운로드 페이지로 이동하도록 변경했습니다.
운영 중 들어온 피드백을 버그 제보로만 보지 않고, 사용자가 서비스를 어떻게 이해하고 있는지 확인하는 근거로 활용했습니다.
Engineering
운영을 지탱할 수 있도록 데이터와 코드의 기준을 다시 세웠습니다.
1,603줄의 관리자 페이지를 어떻게 나눌 것인가
문제 정의
v1 관리자 페이지는 1,603줄까지 증가하면서 API 호출, 데이터 변환, 모달 상태, 사용자 액션, UI 렌더링이 하나의 파일 안에 모여 있었습니다.
문제는 단순히 코드가 길어진 것이 아니라, 서로 다른 이유로 변경되는 기능들이 한곳에 섞여 있다는 점이었습니다. 기능 하나를 수정할 때 다른 관리 기능에 미치는 영향까지 함께 확인해야 했고, 새로운 기능이 추가될수록 변경 범위를 파악하기 어려워지고 있었습니다.
어디까지 공통화할 것인가
처음에는 반복되는 관리자 화면을 공통 컴포넌트로 묶는 방향을 고려했습니다. 하지만 화면이 비슷하다는 이유만으로 기능을 하나로 합치면, 도메인마다 다른 API와 사용자 행동을 처리하기 위한 조건이 계속 늘어날 수 있었습니다.
세탁기와 건조기는 보여주는 데이터만 다를 뿐, 관리자가 상태를 확인하고 조작하는 방식과 변경 이유가 거의 같았습니다. 이런 기능은 같은 컴포넌트를 재사용하는 편이 자연스러웠습니다.
반대로 예약 이력과 기기 관리는 화면 형태는 비슷해 보여도 사용하는 API와 사용자가 수행하는 행동이 달랐습니다. 이를 하나의 범용 컴포넌트로 묶으면 한 기능의 변경이 다른 기능까지 영향을 줄 수 있다고 판단했습니다.
변경 이유를 기준으로 경계를 나눴습니다.
그래서 화면이 비슷하게 생겼는지보다, 같은 이유로 변경되고 같은 사용자 행동을 가지는지를 기준으로 컴포넌트 경계를 정했습니다.
변경 이유와 사용자 행동이 같음
→ 동일 컴포넌트 재사용
외형은 비슷하지만 API·사용자 행동이 다름
→ 별도 도메인 컴포넌트 유지
도메인과 관계없이 반복되는 UI만 더 작은 단위로 분리했습니다.
- 패널의 공통 외형 →
StatusPanelShell - 행 단위 액션 배치 →
StatusRowActions
공통 UI는 한곳에서 수정할 수 있도록 하고, 기기·예약·사용자처럼 각 기능의 동작은 해당 도메인 안에 남겼습니다.
결과
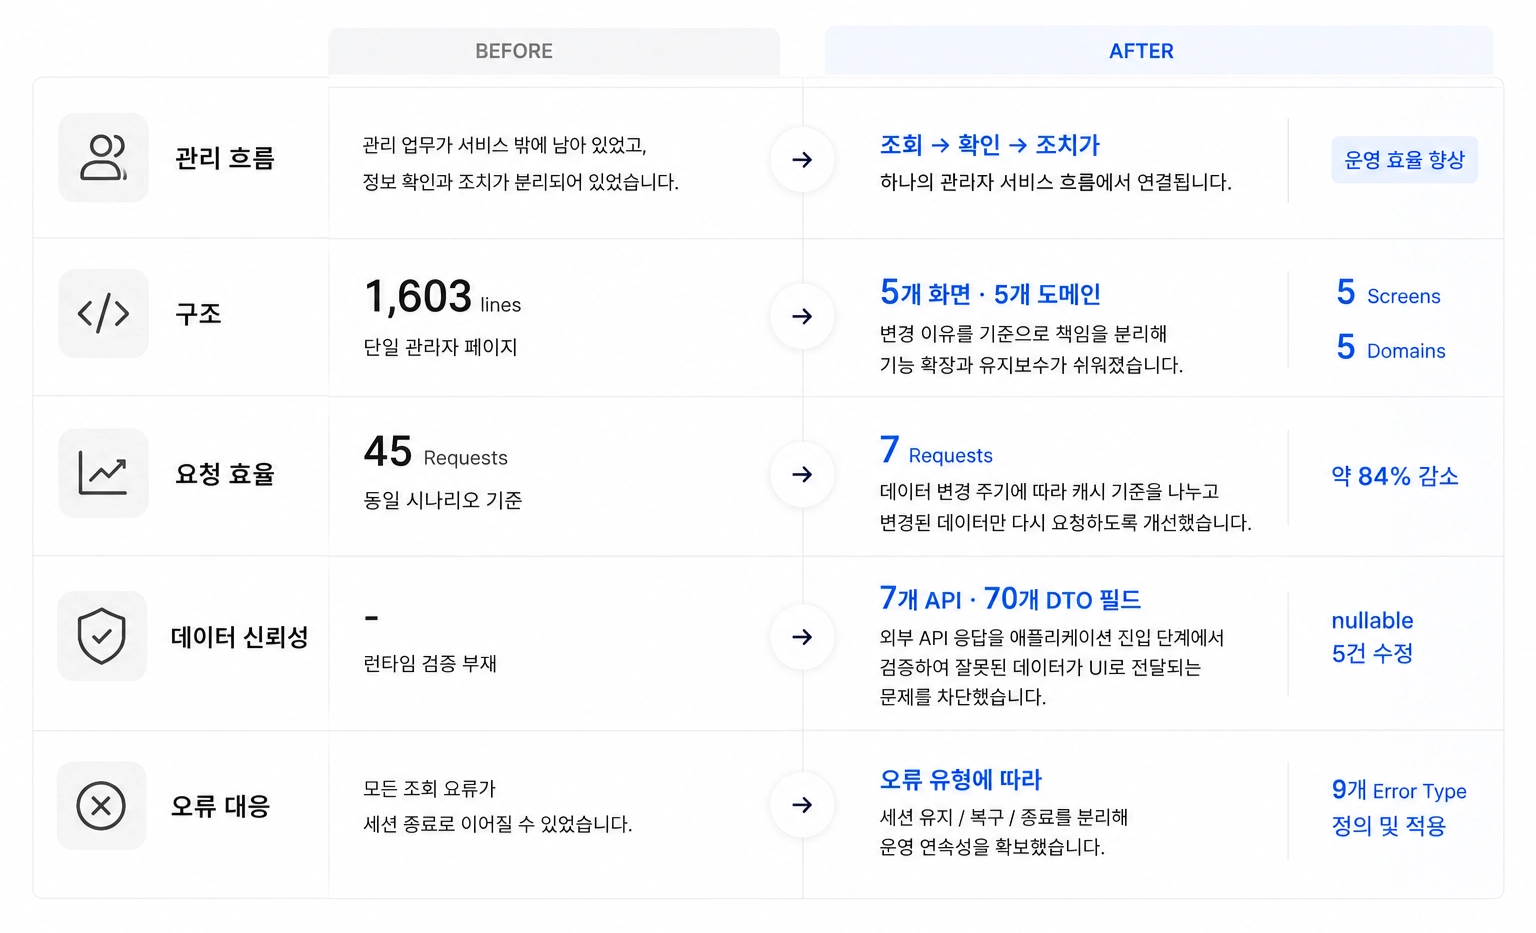
결과적으로 1,603줄의 단일 관리자 페이지를 5개 화면·5개 도메인 구조로 분리했습니다.
단순히 파일 수를 늘리는 것이 아니라, 공통 UI와 도메인 기능의 책임을 분리해 한 기능의 변경이 다른 관리 영역까지 퍼지는 범위를 줄였습니다.
공통화는 화면이 비슷한지를 기준으로 하기보다, 같은 이유로 변경되고 같은 사용자 행동을 가지는지를 기준으로 판단해야 한다는 기준을 얻었습니다.
PR #10 — core entity structure and admin query flow
최신성을 유지하면서 요청을 어떻게 줄일 것인가
같은 데이터를 반복해서 요청하고 있었습니다.
관리자 화면에서는 대시보드·기기·예약·신고·사용자 페이지를 오가며 같은 서버 데이터를 반복해서 사용합니다.
v1에서는 서버 데이터를 화면 로컬 상태로 관리해 화면에 다시 진입할 때마다 같은 데이터를 요청했고, v2 초기에도 staleTime 기준이 없어 불필요한 재요청이 이어졌습니다.
실제로 대시보드 → 기기 → 예약 → 신고 → 사용자 → 대시보드 → 기기 → 예약 순서로 동일한 관리자 탐색 시나리오를 수행했을 때 API 요청은 45건 발생했습니다.
캐시 시간을 길게 두는 것만으로 충분할까
요청 수만 줄이는 것이 목적이라면 모든 Query의 캐시 시간을 길게 설정할 수도 있었습니다.
하지만 관리자 화면의 데이터는 모두 같은 속도로 변하지 않았습니다.
기기 상태는 사용자가 기기를 사용하는 순간 바뀔 수 있지만, 관리자 본인 정보는 로그인 세션 동안 거의 변하지 않습니다.
모든 데이터를 같은 시간 동안 최신이라고 판단하면, 기기 상태처럼 자주 변하는 데이터의 최신성이 떨어질 수 있습니다. 반대로 모든 데이터를 짧게 유지하면 거의 변하지 않는 정보까지 계속 다시 요청하게 됩니다.
그래서 단순히 캐시 시간을 늘리는 대신, 각 데이터를 얼마 동안 최신으로 신뢰할 수 있는지를 먼저 구분하기로 했습니다.
데이터의 변경 주기로 신선도 기준을 나눴습니다.
데이터가 실제로 얼마나 자주 바뀌는지를 기준으로 staleTime을 나눴습니다.
| 데이터 | staleTime | 기준 |
|---|---|---|
| Machine | 30초 | 사용 상태가 비교적 빠르게 변경 |
| Reservation | 1분 | 예약 생성·취소로 주기적으로 변경 |
| Report | 3분 | 기기 상태보다 변경 빈도가 낮음 |
| User | 3분 | 관리자 조치가 있을 때 주로 변경 |
| My Info | 30분 | 로그인 세션 중 거의 변경되지 않음 |
이 기준은 STALE_TIME으로 한곳에 정의해 각 Query에서 동일하게 사용했습니다.
export const STALE_TIME = {
  MACHINE: 30 * SECOND,
  RESERVATION: MINUTE,
  REPORT: 3 * MINUTE,
  USER: 3 * MINUTE,
  MY_INFO: 30 * MINUTE,
} as const;
다만 캐시가 남아 있더라도 예약 취소나 기기 상태 변경이 발생하면 기존 데이터는 더 이상 최신 상태가 아닙니다.
그래서 v1처럼 Mutation 이후 조회 함수를 직접 다시 호출하는 대신, 데이터가 실제로 변경됐을 때 관련 Query만 invalidate하도록 갱신 기준도 함께 정리했습니다.
onSuccess: () => {
  queryClient.invalidateQueries({
    queryKey: reservationQueryKeys.all,
  });
};
평소에는 캐시된 데이터를 재사용하고, 실제 변경이 발생한 경우에만 필요한 데이터를 다시 요청하도록 구성했습니다.
결과
동일한 관리자 탐색 시나리오로 다시 측정한 결과, API 요청은 45회에서 7회로 약 84% 감소했습니다.
| 개선 전 | 개선 후 | 감소율 |
|---|---|---|
| 45회 | 7회 | 약 84% |
반복 요청을 줄이면서도 기기·예약처럼 변경 빈도가 높은 데이터는 짧은 신선도 기준을 유지해, 요청 수와 최신성 중 하나를 포기하지 않도록 조정했습니다.
서버 상태를 최적화할 때는 캐시 시간을 일괄적으로 늘리기보다, 데이터의 변경 주기와 다시 갱신해야 하는 시점을 함께 정의해야 한다는 기준을 얻었습니다.
실제 API 응답을 어디까지 신뢰할 것인가
타입을 선언했지만, 실제 응답까지 보장되지는 않았습니다.
v2의 주요 조회 API에서는 TypeScript 제네릭으로 서버 응답 형태를 정의하고 있었습니다.
get<BaseResponseType<UserResponseType>>(userUrl.getUsers());하지만 TypeScript 타입은 코드에서 기대하는 형태를 표현할 뿐, 실제 서버에서 전달된 데이터가 그 형태인지 런타임에서 확인하지 않습니다.
실제 API를 연동하는 과정에서도 선언과 응답이 다른 사례가 발견됐습니다.
예를 들어 penaltyExpiresAt은 기존 타입에서 string으로 정의되어 있었지만, 패널티가 없는 사용자의 실제 응답에서는 null이 내려올 수 있었습니다.
// 기존 타입
penaltyExpiresAt: string;

// 실제 응답을 반영한 Schema
penaltyExpiresAt: z.string().nullable();
nullable 필드뿐 아니라 필드 누락이나 예상하지 않은 상태값이 전달되더라도, 기존 구조에서는 데이터가 UI에 사용된 이후에야 문제가 드러날 수 있었습니다.
외부 데이터가 들어오는 지점에서 검증하기로 했습니다.
서버 응답을 TypeScript 타입만으로 신뢰하기보다, 애플리케이션에 들어오는 시점에서 실제 데이터를 검증하는 경계가 필요하다고 판단했습니다.
그래서 API 응답을 unknown으로 받은 뒤 Zod Schema를 통과한 데이터만 이후 로직에서 사용할 수 있도록 변경했습니다.
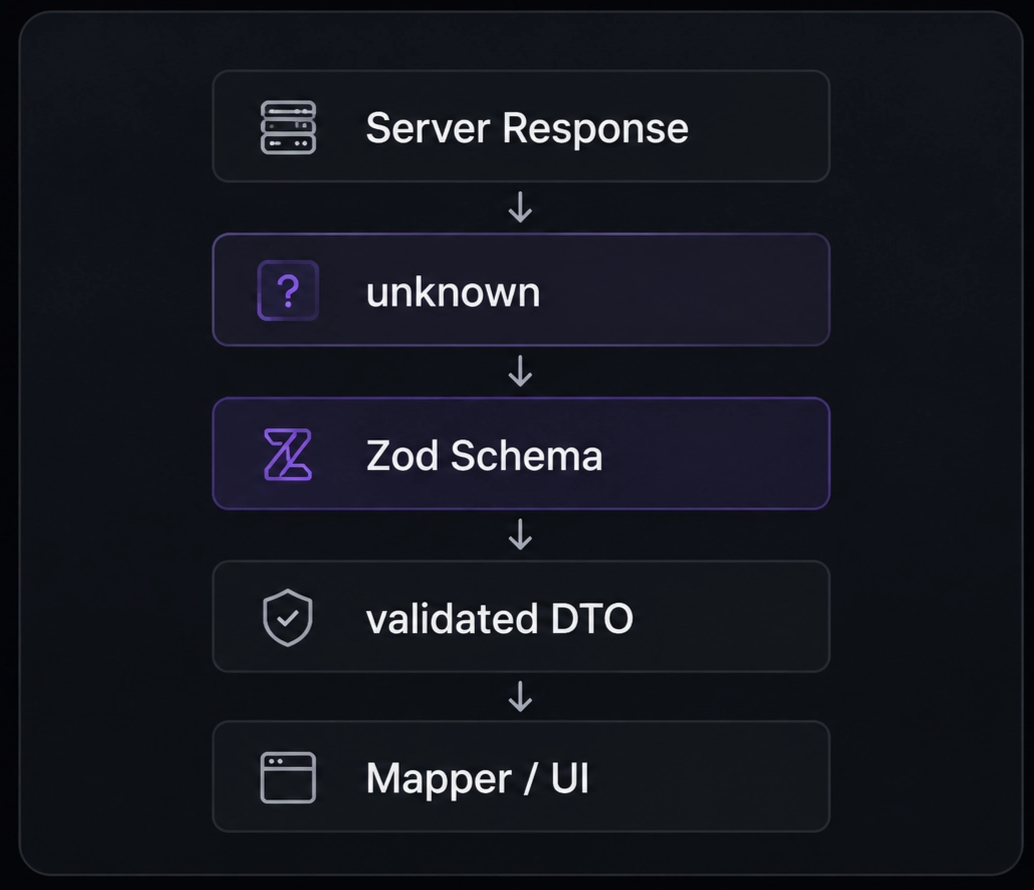
Reservation·Machine·User·Report·Dashboard의 주요 조회 응답에 Schema를 적용하고, TypeScript 타입도 Schema에서 추론하도록 구성해 타입 선언과 런타임 검증 규칙을 하나의 기준으로 관리했습니다.
기기 API의 status, availability, position처럼 정해진 값만 받아야 하는 필드는 z.enum()으로 제한해 예상하지 않은 상태값도 API 진입 단계에서 확인할 수 있도록 했습니다.
DTO와 UI Model을 어디까지 분리할 것인가
응답 검증을 적용하면서, API Response DTO와 UI Model을 어디까지 분리해야 하는지 프론트엔드 팀원과 기준을 논의했습니다.
처음에는 서버 응답을 ReportDTO로 받고, mapReport에서 상태값과 필드를 화면에 필요한 형태로 변환한 뒤 UI에서는 별도의 ReportItem을 사용하는 방식을 제안했습니다.
이 방식은 컴포넌트가 API 스펙에 직접 의존하지 않는다는 장점이 있었습니다.
반면 팀원은 실제 변환이 거의 없는 데이터까지 DTO와 UI Model로 나누면 관리해야 할 타입과 변경 지점만 늘어날 수 있다는 의견을 주었습니다.
당시 Report 데이터는 별도의 필드 변환이 거의 필요하지 않았기 때문에, 모든 응답에 동일한 구조를 적용하는 것보다 실제 변환 필요 여부를 기준으로 나누는 편이 더 단순하다고 판단했습니다.
별도 변환이 필요 없음
→ 검증된 DTO 그대로 사용
UI 표현을 위한 변환이 필요함
→ Mapper 적용
팀 논의를 통해 모든 응답에 Mapper를 일괄 적용하지 않고, Zod 검증 이후 추가적인 UI 변환이 필요한 경우에만 Mapper를 사용하도록 기준을 정했습니다.
결과
그 결과 5개 도메인의 7개 주요 API, 70개 DTO 필드를 런타임에서 검증하도록 변경했습니다.
이 과정에서 실제 API 응답과 기존 타입 선언이 달랐던 nullable 필드 5건을 수정했고, 검증되지 않은 외부 데이터가 Mapper와 UI까지 전달되지 않도록 차단했습니다.
또한 타입과 검증 규칙을 Schema를 기준으로 관리하면서, 서버 응답 구조가 변경됐을 때 확인해야 할 지점도 명확해졌습니다.
TypeScript로 기대하는 형태를 선언하는 것과 실제 외부 데이터를 신뢰하는 것은 별개의 문제이며, 애플리케이션 경계에서 실제 응답을 검증해야 한다는 기준을 얻었습니다.
PR #19 — 주요 조회 API 응답 검증 및 데이터 흐름 개선
어떤 오류에서 세션을 종료할 것인가
모든 조회 실패를 로그인 만료로 처리하고 있었습니다.
관리자 화면에서는 로그인한 관리자의 권한과 정보를 확인하는 useGetMyInfo 요청이 실패하면, 오류 원인을 구분하지 않고 로그인 세션을 정리하고 있었습니다.
if (isMyInfoError) {
  queryClient.clear();
  deleteCookie(ACCESS_TOKEN);
  deleteCookie(REFRESH_TOKEN);
  window.location.href = "/sign-in";
}
처음에는 내 정보 조회 실패를 로그인 만료로 처리해도 큰 문제가 없어 보였습니다.
하지만 API 응답에 Zod 검증을 적용하면서, 인증과 관계없는 응답 검증 오류도 TanStack Query의 isError로 전달되고 그대로 강제 로그아웃으로 이어질 수 있다는 문제가 드러났습니다.
Zod 검증 실패
    ↓
Query isError
    ↓
로그인 만료로 오판
    ↓
Cache / Token 삭제
    ↓
강제 로그아웃
문제는 isError가 요청이 실패했다는 사실만 알려줄 뿐, 왜 실패했는지는 구분하지 않는다는 점이었습니다.
실패 여부보다, 복구할 수 있는 오류인지 구분하기로 했습니다.
서버 오류나 네트워크 장애처럼 일시적인 문제까지 인증 만료와 동일하게 처리하면, 사용자가 다시 로그인해도 해결되지 않는 문제 때문에 현재 세션까지 잃게 됩니다.
반대로 실제 Access Token 만료와 같이 인증을 복구할 수 없는 상황에서는 세션을 정리하고 다시 로그인하도록 안내해야 했습니다.
그래서 요청의 성공·실패만으로 세션 상태를 결정하지 않고, 실패 원인과 복구 가능성을 기준으로 대응을 나누기로 했습니다.
오류를 공통 모델로 정규화했습니다.
Axios와 Zod에서 서로 다른 형태로 발생하던 오류를 공통 AppError로 변환했습니다.
내 정보·사용자·기기·예약·대시보드·고장 신고 등 7개 조회 API와 5개 Mutation, 총 12개 API 요청에서 발생하는 오류를 9개 유형으로 분류했습니다.
- 인증
- 권한
- 잘못된 요청
- 리소스 없음
- 충돌
- 서버
- 네트워크
- 응답 검증
- 알 수 없는 오류
이후 오류 유형에 따라 사용자의 세션과 다음 행동을 다르게 처리했습니다.
AUTHENTICATION
→ 인증 복구 시도 → 실패 시 세션 정리 → 로그인
SERVER / NETWORK / VALIDATION
→ 세션 유지 → 오류 안내 / 재시도
FORBIDDEN
→ 세션 유지 → 접근 차단
401도 바로 로그아웃하지 않도록 변경했습니다.
최초 401 응답 역시 곧바로 인증 실패로 확정하지 않았습니다.
Access Token이 만료된 경우에는 Refresh Token을 이용해 토큰 재발급을 먼저 시도하고, 재발급까지 실패해 더 이상 인증을 복구할 수 없을 때만 Query Cache와 토큰을 정리하도록 변경했습니다.
이를 통해 일시적인 인증 만료는 사용자가 다시 로그인하지 않아도 복구하고, 실제로 인증 상태를 복구할 수 없는 경우에만 세션을 종료하도록 기준을 명확히 했습니다.
결과
서버·네트워크·API 응답 검증 오류에서는 기존 로그인 상태를 유지하고, 실제 인증 복구가 실패한 경우에만 세션을 종료하도록 변경했습니다.
또한 주요 조회·Mutation API에서 발생하는 오류를 하나의 기준으로 정규화하면서, 각 기능에서 개별적으로 오류 원인을 해석하지 않고 오류 유형에 따라 사용자 대응 방식을 일관되게 적용할 수 있도록 정리했습니다.
요청이 실패했다는 사실만으로 사용자 상태를 변경하기보다, 실패 원인과 복구 가능성을 먼저 구분해야 한다는 기준을 얻었습니다.
Impact
처음 정의한 두 가지 문제를 실제 운영과 구조의 변화로 연결했습니다.
- 운영 — 서비스 밖에 남아 있던 관리 업무를 내부로 가져왔습니다.
기기 상태, 예약, 사용자, 고장 신고처럼 분산되어 있던 관리 정보를 Dashboard · Machines · Reservations · Users · Reports로 나누고, 대상을 찾고 → 관련 정보를 확인하고 → 필요한 조치까지 이어지는 흐름으로 재설계했습니다.
그 결과 관리자가 수기로 정보를 확인하거나 여러 경로를 오가는 대신, 하나의 관리자 서비스 안에서 운영 상황을 확인하고 직접 대응할 수 있는 구조를 만들었습니다.
- 구조 — 기능이 늘어나도 관리할 수 있는 기준을 만들었습니다.
1,603줄의 단일 관리자 페이지를 5개 화면·5개 도메인으로 분리하고, 화면의 형태보다 변경 이유와 사용자 행동을 기준으로 책임을 나눴습니다.
또한 데이터의 변경 주기에 따라 캐시 기준을 정하고, API 응답 검증과 오류 복구 정책을 명시하면서 요청 수를 45회에서 7회로 약 84% 줄이고, 외부 데이터와 실패 상황을 일관된 기준으로 처리할 수 있도록 구조를 정리했습니다.
서비스 밖에 남아 있던 운영 흐름은 관리자 서비스 안으로 가져오고, 코드 안에 흩어져 있던 데이터 처리 기준은 명확한 구조와 정책으로 정리했습니다.
v1에서 v2로, 이렇게 달라졌습니다.
Retrospective
좋은 구조는 변화와 실패를 다루는 기준에서 시작했습니다.
Washer v2를 시작할 때는 기존 관리자 화면을 다시 만들고 기능을 연결하는 것이 가장 큰 과제라고 생각했습니다.
하지만 실제 운영 과정과 코드를 함께 들여다보면서, 문제는 개별 기능보다 운영 방식과 데이터 처리 기준이 명확하지 않은 데서 반복해서 생긴다는 것을 알게 됐습니다.
1,603줄의 관리자 페이지를 나누는 과정에서는 단순히 파일을 작게 만드는 것보다 같은 이유로 변경되는 기능을 어디까지 함께 둘 것인지가 중요했습니다.
서버 상태를 다루면서는 캐시 자체보다 데이터를 얼마나 오래 신뢰할 것인지, API 응답과 오류를 다루면서는 외부 데이터를 어디서부터 신뢰하고 어떤 실패까지 복구할 것인지를 먼저 정해야 했습니다.
특히 DTO와 UI Model의 분리 기준을 팀원과 논의하면서, 제가 제안한 구조가 항상 정답인 것은 아니라는 점도 배웠습니다.
추상화를 일괄 적용하기보다 현재 데이터의 변환 필요성과 변경 가능성을 기준으로 팀이 함께 판단하는 과정이 더 중요했습니다.
다음 프로젝트에서는
이번에는 기능을 구현한 뒤 문제를 발견하면서 캐시 정책, 응답 검증, 오류 처리 기준을 하나씩 정리한 경우가 많았습니다.
다음 프로젝트에서는 개발 초기에 데이터의 변경 주기, API 응답 검증 범위, 오류별 복구 기준처럼 반복해서 영향을 주는 정책을 먼저 정의하고, 구현 과정에서 결정한 이유를 PR이나 문서에 남기려고 합니다.
이번 프로젝트를 통해 좋은 구조는 패턴을 많이 적용하는 것보다, 변화와 실패를 어떤 기준으로 다룰지 팀이 함께 정하는 데서 시작된다는 것을 배웠습니다.